Redis 특징, 데이터 타입, 백업, 아키텍처
Redis 특징
1. Redis와 RDBMS와 가장 큰 차이점은 데이터 저장 위치이다.
- RDBMS → Disk 에 저장
- Redis → Disk & Memory 에 저장
Memory에 저장이 된다는 부분은 캐싱이 가능하다는 뜻이고, 이는 즉 Data 처리 속도가 매우 빠르다는 뜻이다.
Memory는 휘발성이라 재부팅시 Data가 날라가는데, Redis는 Disk 저장 기능도 같이 지원하므로 Data 보존이 가능하다.
2. 굉장히 많은 자료구조를 지원하기 때문에 개발 편의성을 높여준다.
- String, Bitmaps, Lists, Hashes, Sets, Sorted Set, Streams
캐싱 전략
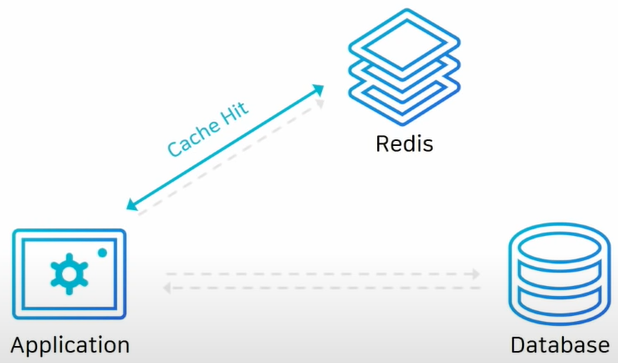
1. 읽기 전략 : DB보다 캐시를 먼저 읽는다.
만약 캐시에 찾는 데이터가 없으면, DB를 뒤진 후 이를 다시 캐시에 올려둔다.
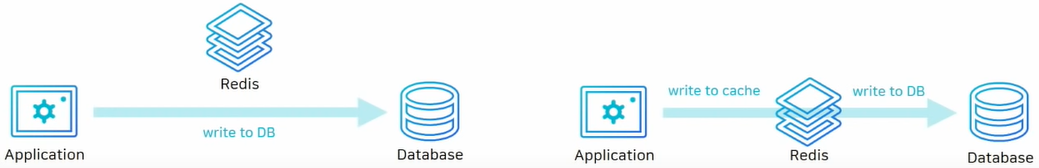
2. 쓰기 전략 : Data를 저장 할때 캐시도 같이 챙겨 줄건지에 따라 아래 2가지 방식이 있다.
데이터 타입 활용 방법
1. Counting
- String 타입 : INCR / INCRBY 명령어로 카운팅 가능
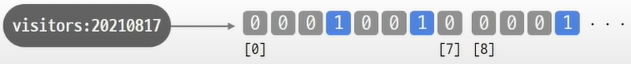
- Bits 타입 : 특정 날짜에 접한 유저수를 카운팅 할때, 아래와 같이 각각의 bit가 유저 1명을 뜻한다.
1로 설정되어 있는 사람들만 접속한 사람들이기 때문에 1만 카운팅하면 된다.
- HyperLogLogs 타입 : 대용량 데이터를 카운팅 할때 적절하며, 용량은 12KB로 고정
2. Messaging
- Lists 타입 : Blocking 기능을 이용해 Event Queue로 사용.
키가 있을대만 데이터 저장 가능 - Streams 타입 : 로그를 저장하기 가장 적절한 자료구조.
시간 범위로 검색 / 신규 추가 데이터 수신.
Kafka를 간단하게 대체 할수 있는 자료구조.
데이터 영구 저장 방법
1. AOF(Append Only File) : 장애 상황 직전까지의 모든 데이터가 보장되어야 할 경우
2. Snapshot (RDB) : 백업은 필요하지만, 어느 정도의 데이터 손실이 발생해도 괜찮은 경우
※ 제일 좋은 방식은 위 2가지 동시에 사용하는것이 좋다
Redis 아키텍처
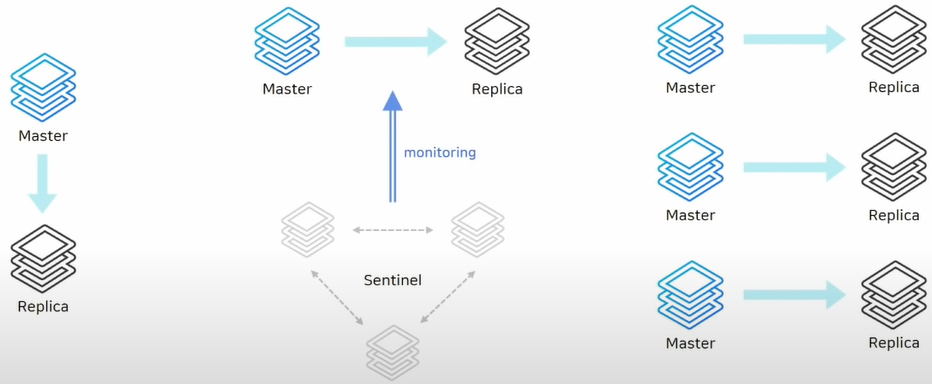
1. Replication : 복제 기능 (HA 기능이 없으므로 장애 상황 시 수동 복구)
2. Sentinel : HA 기능 (High Availability)
3. Cluster : HA 기능 + 샤딩 기능
지양해야 되는 커맨드
Redis는 Single Thread로 동작 하기에 시간이 오래걸리는 커맨드는 지양하자.
1. keys * 커맨드는 모든 자료를 서칭하기에 Redis 부하가 생긴다 → scan으로 대체해서 사용하자.
2. 하나의 키에 최대 100만개 이상은 저장하지 말자
3. del 명령어는 자료를 지우는 동안 다른 작업 불가 → unlink는 백그라운드에서 지우기 때문에 권장
MaxMemory 값 설정시 주의
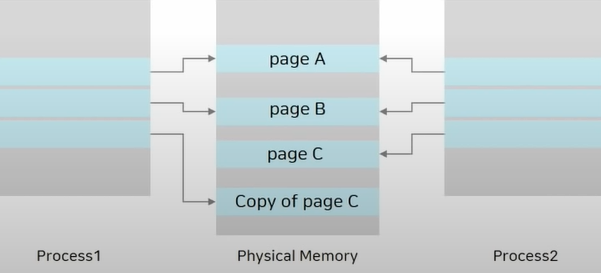
- Snapshot & AOF rewrite 시 fork()
- Copy-on-Write로 인해 메모리를 두배로 사용하는 경우 발생 가능
- Persistence / 복제 사용시 MaxMemory는 실제 메모리의 절반으로 설정
ex) 4 GB → 2048 MB